Уряди й міжнародні інституції нарешті прокидаються: ШІ-контент потрібно маркувати! Євросоюз уже підготував статтю 50 Акту про штучний інтелект (AI Act Article 50), яка зобов’язує видавців і постачальників технологій розкривати дані про застосування автоматичної генерації. Водночас бізнес намагається зрозуміти, що станеться з позиціями його сайтів і чи не почне плашка «створено ШІ» відлякувати покупців. І взагалі, навіщо ставити цю плашку, якщо моделі вже навчилися створювати непогані тексти, зображення й відео?
Цікаво, що аудиторія ставиться до штучного інтелекту спокійніше за законотворців і маркетологів. В експерименті з 1601 учасником позначення політичних повідомлень як згенерованих ШІ не зменшило їхньої переконливості. Інше дослідження за участю 911 осіб не виявило значущої зміни готовності лайкати, коментувати й поширювати контент через наявність ШІ-позначки. Тож люди оцінюють зміст і якість контенту, а також дивляться на те, наскільки він відповідає їхнім очікуванням. Авторство ж зазвичай лишається необов’язковою фоновою інформацією.
І саме тут може критися підступ! Переконливий текст здатний однаково добре пояснити вибір холодильника і продати небезпечну нісенітницю. Тож розберемося, чому стривожилися наглядові органи, чого вони вимагають від авторів і видавців, та як бізнесу підготуватися до наступного повороту.
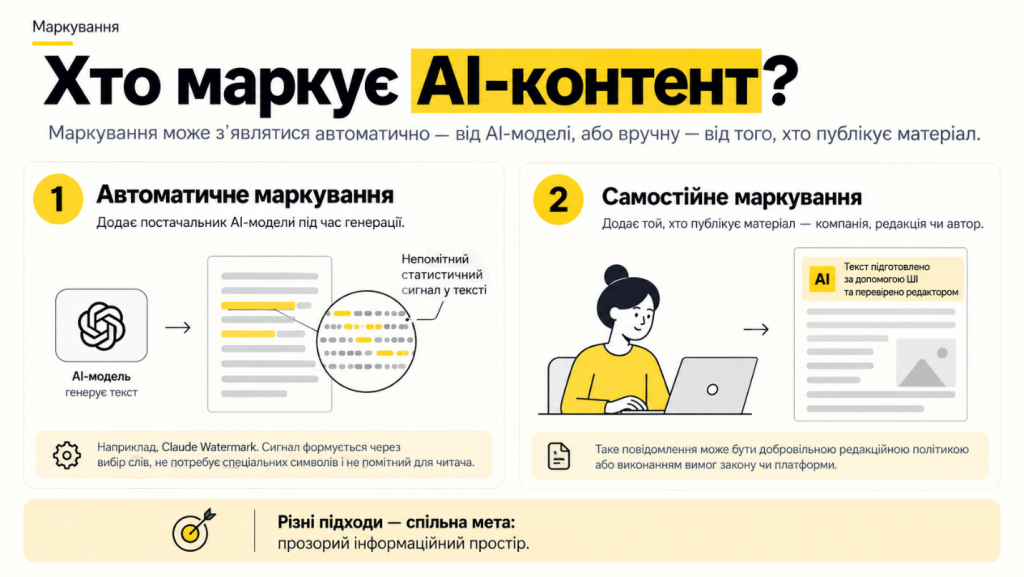
Про яке маркування йдеться
Автоматичне маркування додає постачальник ШІ-моделі під час генерації. Перший приклад — Claude Watermark: непомітний для читача статистичний сигнал у тексті. Для його появи не потрібно ставити галочку чи дописувати «створено Claude». Anthropic пояснює, що сигнал формується саме через вибір слів, які утворюють математичну мережу в тексті: йому не потрібні приховані символи, які можна видалити за кілька кліків.
Але відповідальність несе не тільки розробник штучного інтелекту, а й бізнес, який застосовує його з комерційною метою.
Отже, самостійне маркування додає той, хто публікує матеріал. Наприклад: «Текст підготовлено за допомогою ШІ та перевірено редактором». Таке повідомлення може бути добровільною редакційною політикою або виконанням вимоги закону чи платформи. Читач бачить його без застосування спеціальних інструментів.
Чому маркування взагалі знадобилося
ШІ не має людської емпатії, не гарантує дотримання законів і взагалі часто просто глючить. Термін «машинна галюцинація» з’явився не на порожньому місці. І добре, якщо помилка просто зробить вашу страву несмачною чи створить надлишковий запас товару на складі. Досвід показує, що іноді ціною машинної галюцинації є життя та здоров’я людини.
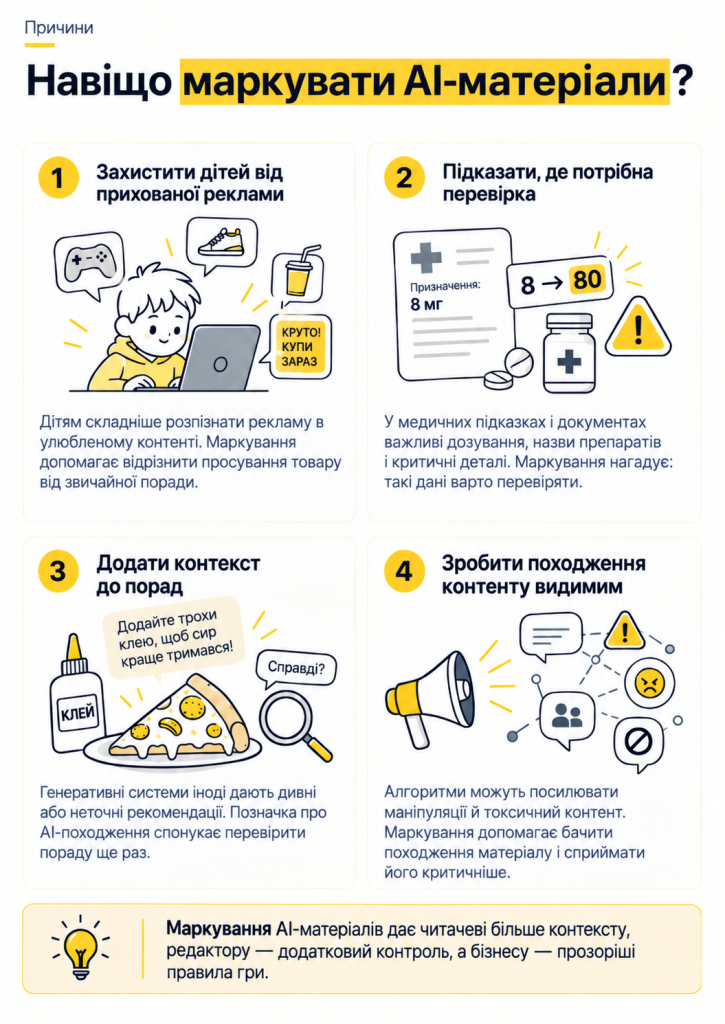
Купіть напій, щоб не відстати від інших
У липні 2026 року польський антимонопольний орган UOKiK висунув претензії блогерам Wojan і Palion. У своїх Minecraft-каналах з дитячою аудиторією вони продавали власні напої та мерч, мотивуючи глядачів дефіцитом і популярністю товарів серед однолітків. Реклама ставала частиною самої гри — у Minecraft навіть з’явилися магазини з брендованими напоями.
Регулятор побачив у цьому ознаки агресивного маркетингу. Дитина сіла дивитися улюбленого блогера, а опинилася під тиском: інші вже купили, товар закінчується, треба встигнути.
Так само команда ютуберів Ekipa Friza просувала морозиво Koral Ekipa, збільшивши його продажі на 300% відносно інших нових продуктів компанії. Це стало можливим завдяки яскравому інфлюенсерському маркетингу та штучному ажіотажу серед дитячої аудиторії.
А тепер уявіть, що солодощі та дорогі трендові товари просувають не блогери з універсальним меседжем для всього світу, а спеціально створений віртуальний персонаж. Він знає, що любить дитина, пам’ятає кожне її слово і вміє переконувати.
Можливості для продажів прекрасні. Причини для занепокоєння регулятора та батьків — також.
Вісім(десят) одиниць інсуліну
Наступний приклад трагічний. Американський Інститут безпечного застосування ліків ISMP описав випадок, у якому система розпізнавання мовлення записала дозу інсуліну 80 одиниць замість 8. Лікар не помітив помилки. В результаті, пацієнт помер після переведення до реабілітаційного закладу.
Ще одна ситуація демонструє важливість людського втручання в AI-пайплайн. Лікар помилково вибрав із запропонованого системою списку прокарбазин — хіміотерапевтичний препарат. У призначенні з’явилося 50 мг перорально замість потрібних 5 мг прохлорперазину внутрішньовенно. На щастя, фармацевт звернув увагу, що в пацієнта немає онкологічного діагнозу, і зв’язався з лікарем. Помилкове призначення скасували.
І це не поодинокі випадки! У дослідженні JMIR Medical Informatics 2026 року серед 356 перевірених AI-записів лікарі виявили пропуски інформації у 18%, галюцинації — у 11,5%, а 5,3% записів містили помилки з потенційно серйозним ризиком для пацієнта.
Клей до піци й каміння на сніданок
У 2024 році Google AI Overviews радили додавати клей до піци, щоб сир краще тримався, та з’їдати щонайменше один камінь на день. Система сприйняла жартівливий коментар і сатиричну публікацію The Onion як матеріал для відповіді. Google офіційно визнала обидва випадки й повідомила про зміни в роботі пошуку.
Над камінням ще можна посміятися, бо помилку видно одразу. Натомість із дозуванням препарату все складніше: відповідь може мати цілком професійний вигляд. Тому читач має знати, що текст автоматично згенерований, — так у нього буде привід перевірити пораду. А видавець отримає сигнал, що сирий текст не можна просто так віддавати в публікацію.
Коли алгоритм впливає на життя суспільства
Втрата одного життя — трагедія. Але зловживання штучним інтелектом може мати значно масштабніші наслідки.
У книжці Nexus Юваль Ной Харарі описує, як алгоритм Facebook створив умови для геноциду народу рохінджа в М’янмі. Якщо коротко, алгоритми максимізували залучення та поширювали дописи, що викликали сильні негативні реакції. У цьому конкретному випадку це були відео, що закликали до насильства проти представників конкретної національної меншини.
Розслідування Amnesty International підтвердило, що на роботі систем платформи лежить значна відповідальність за трагедію 2017 року.
Зауважте, що це були старі алгоритми. Якщо ж додати до них LLM, можливі наслідки страшно собі уявити.
Тож вимога повідомляти про штучне походження контенту — це дуже скромний запобіжник.
Кого стосується AI Act і що він вимагає
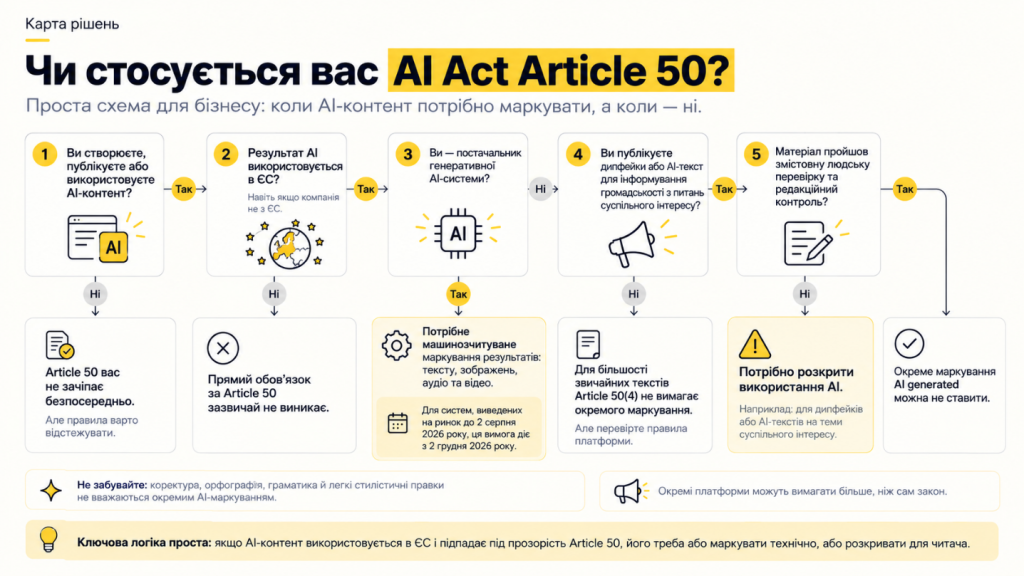
Відповідно до статті 50 AI Act постачальники генеративних систем мають забезпечити машинозчитуване маркування їхніх результатів. Це стосується синтетичного тексту, зображень, аудіо та відео.
Компанії, які використовують ШІ, мають розкривати його застосування у визначених законом випадках. Зокрема, коли публікують дипфейки або згенеровані чи змінені ШІ-тексти для інформування громадськості з суспільних питань.
Статтю 50 AI Act застосовують з 2 серпня 2026 року. Контент, створений раніше, маркувати заднім числом не потрібно. Для AI-систем, виведених на ринок до цієї дати, вимоги щодо маркування починають діяти з 2 грудня 2026 року. Норма стосується і компаній за межами ЄС. Тож якщо ваш бізнес має продажі чи клієнтів у Євросоюзі, дотримуйтеся статті 50 AI Act.
Теоретично, під дію AI Act підпадають лише тексти, які стосуються:
- політики й демократичних процесів;
- урядування, суспільних послуг і самоуправління;
- судових і юридичних процесів;
- невід’ємних людських прав;
- громадського здоров’я;
- безпеки споживачів;
- фінансів;
- захисту довкілля;
- фінансових, політичних, наукових чи культурних тем публічних дебатів.
Але зверніть увагу на останній пункт. Насправді під нього можна підвести будь-який текст. Картку товару — через залежність дітей від смартфонів чи споживання цукру. Редакційну статтю — через дебати навколо AI та агресивного маркетингу. Категорійний текст у каталозі — через обговорення цін на відеокарти і прогнозування цін на чипи.
Також важливо знати, що пункт 4 статті 50 AI Act додає виняток: тексти можна не маркувати, якщо вони проходять редакційний контроль особами чи організаціями, які несуть відповідальність за їхній зміст. З огляду на це можете не застосовувати штамп AI generated, якщо ви:
- ретельно перевірили згенерований текст і готові нести відповідальність за його зміст;
- вивчили, частково переписали та відфактчекали згенерований текст.
Головне — готовність відповідати перед читачами, наглядовими органами та ширшою публікою. Єврокомісія говорить саме про змістовну перевірку згенерованого ШІ тексту людиною з відповідними компетенціями або контроль із правом змінити чи відхилити матеріал.
Правило доволі туманне, але відповідальність за порушення норми цілком реальна — штраф до €15 млн або 3% річного обороту бізнесу в світі (не лише в ЄС). Звісно, не кожен порушник сплачуватиме такі колосальні суми: компетентні органи мають призначати пропорційні санкції, а для малого й середнього бізнесу враховувати його економічну життєздатність. Замість штрафу можуть діяти попередження й альтернативні способи покарання.
Іще кілька моментів, про які слід знати:
- Коректура тексту за допомогою AI не підпадає під обов’язкове маркування. Навіть якщо детектор виявить Claude Watermark, не обов’язково ставити відповідний штампик на сайті. Єврокомісія відносить до такого редагування виправлення орфографії, граматики, пунктуації та легкі стилістичні правки без суттєвої зміни змісту.
- Для очевидно художніх або сатиричних дипфейків передбачена спеціальна форма розкриття, яка не заважає сприйняттю твору. Але якщо така генерація спричинить реальну шкоду, фраза «Ви не розумієте, це постіронія!» у суді не допоможе.
- Цифрові платформи можуть мати окремі внутрішні правила й вимоги. Наприклад, у Google Merchant Center вже необхідно позначати ШІ-зображення, згенеровані назви та описи товарів. Тут ідеться не про штрафи, а про обмеження бізнес-можливостей.
Чи всі LLM уже ставлять водяні знаки
Ні. Наразі впевнено можна говорити лише про два випадки маркування.
Google ще у 2024 році оголосила про застосування SynthID для текстів у Gemini, а Anthropic у серпні 2026 року заявила про плани впровадження подібного механізму в Claude. Нові Claude Fable 5.1 і Mythos 5.1, представлені 1 вересня, уже точно генерують тексти із водяними знаками. А з 1 вересня окремі партнери компанії почали тестувати засоби розпізнавання маркерів.
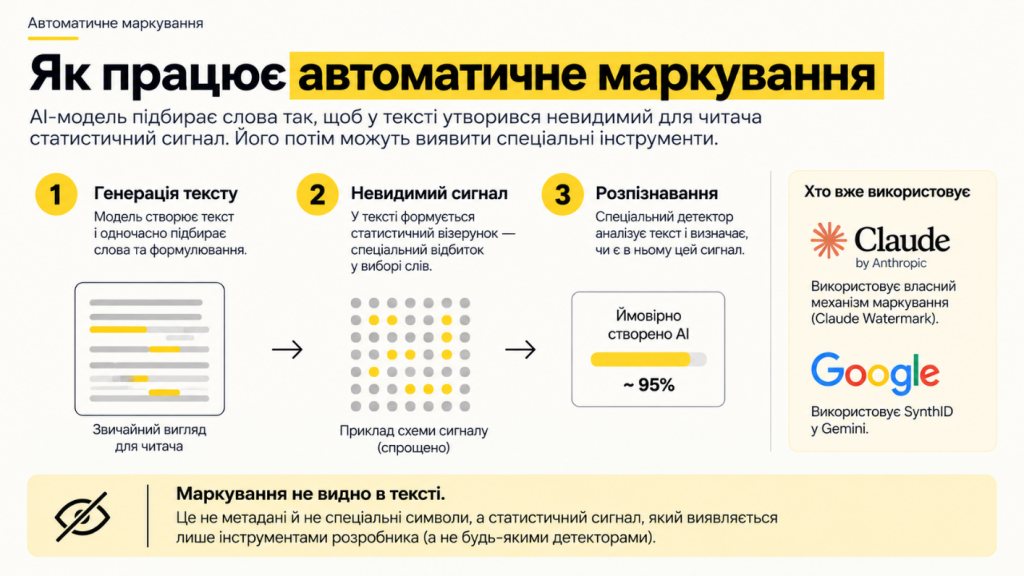
Швидше за все, інші розробники також тестують чи впроваджують приховані механізми визначення походження текстів, не розкриваючи всіх деталей. OpenAI, xAI, Meta, Alibaba та інші компанії не публікують інформації про маркування, але цілком можуть тихо розробляти свої рішення й готувати їх до неочікуваного релізу.
Чи можна давати моделі розпізнавати власний текст? Радше так, ніж ні, але без ключа детекції вона не дасть переконливого результату (і навіть з ключем не забезпечить 100% гарантії). Якщо ж дати одній моделі текст іншого AI-сервісу, результати взагалі будуть непередбачуваними, про що відкрито кажуть спеціалісти Anthropic.
Точно відомо, що моделі зазвичай відмовляються видаляти маркування з власного тексту. Це ми бачили у численних експериментах, коли ChatGPT і Claude казали, що така задача порушує правила сервісу. Але інша модель може й погодитись відредагувати чужий текст. Коли ми досліджували сервіси видалення маркування, то бачили використання локальних моделей з відкритими вагами на кшталт Llama, Qwen та DeepSeek — більш керованих, ніж хмарні платформи.
І нагадаємо: переписування тексту сервісами знищення водяних знаків може суттєво змінювати й погіршувати зміст.
Головне для бізнесу — стежити за AI-законодавством і правилами використання популярних нейромереж, щоб правильно будувати процеси створення та публікації контенту.
Правила змінюватимуться. Сервіси обходу — також
Поки все доволі туманно. До того ж AI Act є сирим і відірваним від реалій, що чудово демонструє фраза про «публічні дебати». Врешті-решт, він лише зараз починає регулювати ринок, який сформувався у 2022–2023 роках. Європейський акт набув чинності у 2024 році, а вимоги статті 50 почали застосовувати лише у 2026 році.
Тому юридичні норми можуть і будуть змінюватися. Наша порада — додати новини про AI Act в закладки чи налаштувати ШІ-агента на відстеження відповідних змін. До речі, це саме той сценарій, де сам AI допоможе уникнути зловживання AI. І це прекрасно, чи не так?
Від технологій теж чекаємо еволюції. На думку нашої команди, ситуація розвиватиметься приблизно так само, як у 2010-х з унікальністю — з’являтимуться точніші детектори й кращі сервіси для їх обходу. У другій половині 2020-х технологічний жабогадюкінг продовжиться: AI-компанії разом із законотворцями вдосконалюватимуть засоби маркування, а хитрі розробники — засоби для видалення водяних знаків. Навіть не сумніваємося, що ця спіраль розкручуватиметься to infinity and beyond.
Чи песимізує Google ШІ-контент
За саме використання ШІ — ні. Експерти Google постійно повторюють, що алгоритм оцінює якість і користь матеріалу, а не його походження. Це твердження прописане і в офіційному гайдлайні щодо створення контенту.
Але від клієнтів ми чуємо, що іноді відмінності в ранжуванні помітні. Наприклад, наші замовники з ніші e-commerce кажуть, що авторський контент працює краще. Але є і ті, хто підтримує платформи із сильним трастом, працюючи лише зі згенерованими матеріалами.
Тож насправді відмінність тонша й менш очевидна. Просідають у ранжуванні низькоякісні матеріали, створені суто для маніпулювання пошуковою видачею і дешевого залучення трафіку.
Це підтверджують дані Ahrefs. У дослідженні 600 тисяч сторінок із ТОП-20 кореляція між оціненою часткою ШІ та позицією становила 0,011 — зв’язок такий непереконливий, що його можна ігнорувати. А у 2026 році компанія виявила 5,3% згенерованих сторінок у Google TОП-3. Так, це дослідження вибірки, а не всього інтернету, але його результати очевидні.
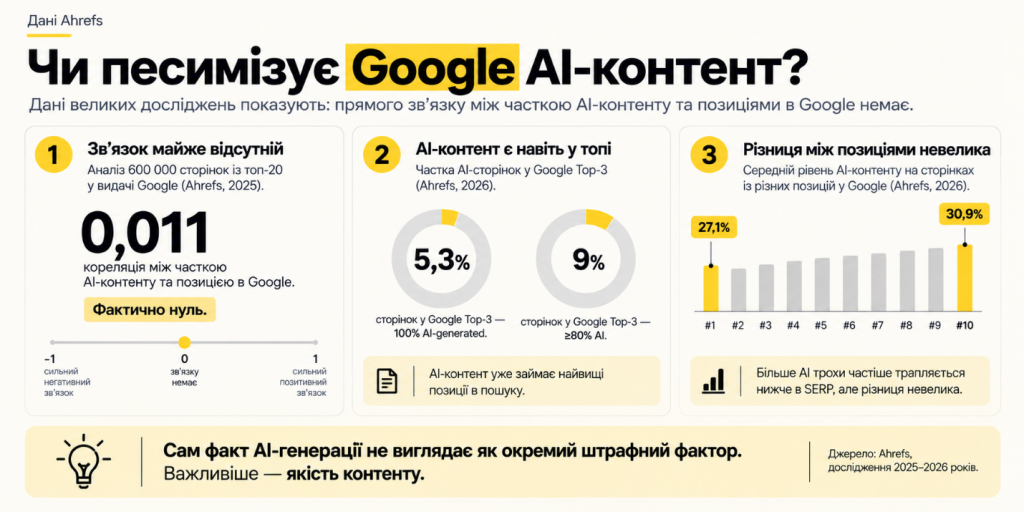
Отже, Google не песимізує контент лише за його штучне походження, а от слабкі матеріали, зроблені суто заради просування, — так.
Тож якщо ви хочете замінити досвідчену команду підпискою на AI-сервіс, зважте все ще раз. Дешевий контент дешево генерувати, але дорого публікувати.
Так, поки що ніхто не збирається знижувати позиції за використання штучного інтелекту. Але щоб перетворити сиру генерацію на пристойний текст, знадобляться професійне редагування, експертна вичитка та коректура. При цьому година праці кваліфікованого редактора може коштувати дорожче за годину професійного райтера. Адже йому доведеться розбирати чужу логіку, відновлювати джерела й виловлювати вигадані подробиці.
Саме тому в 2026–2027 роках тандем автора-експерта і дипломованого редактора залишиться актуальним. Один знає, що й навіщо говорить, а інший доводить матеріал до публікації. Це, звісно, якщо вам потрібен якісний контент.
Як ми визначаємо, що текст написала людина
У WordFactory є власний пайплайн. Його відправна точка — кваліфіковані автори з великим досвідом копірайтингу та чіткою спеціалізацією. Другий етап — сервіси детекції ШІ. Ми використовуємо ZeroGPT, Originality.AI, Grammarly, Quetext та Isgen.AI залежно від завдань і процесів конкретного клієнта.
Але жоден із детекторів не дає стовідсоткової точності — це ми знаємо і за власним досвідом, і за дослідженням 2023 року, яке показало 61,22% хибних спрацювань в есе неносіїв англійської мови.
Тож ключова ланка нашого пайплайну — це дипломований редактор із 15-річним стажем, який виносить фінальний вердикт. Натреноване око помічає типову генерацію: беззмістовні узагальнення, однаковий ритм абзаців, гладкі переходи там, де немає логічного зв’язку. Особливо якщо редактор знає, як автор пише зазвичай. До того ж редактор перевіряє текст на відповідність вимогам клієнта і «допилює» його до ідеалу.
Що робити бізнесу вже зараз
По-перше, з’ясуйте, які правила стосуються саме вашої роботи. Дізнайтеся, чи використовуватимуть ваші тексти і програмні продукти у країнах ЄС. І навіть якщо ні, не розслабляйтеся — США, Канада, Велика Британія, Китай, Японія, Південна Корея та інші потужні цифрові економіки вже розробляють, ухвалюють або розширюють власне AI-законодавство. Уточніть, як пишуть чи генерують тексти, яку обробку вони проходять, хто відповідає за редагування й публікацію.
По-друге, порахуйте залежність бізнесу від AI-генерації контенту. Уявіть песимістичний сценарій, за яким завтра всі згенеровані матеріали почнуть втрачати позиції. Скільки сторінок доведеться переписати? Які з них приносять продажі? Скільки коштуватиме їхнє відновлення? Скільки коштів ви втратите? Звісно, такий сценарій малоймовірний. Але вимоги до контенту зростатимуть, і тексти середнього рівня, до яких сьогодні належить переважна більшість AI-статей, уже незабаром можуть вважатися низькоякісними.
По-третє, напишіть «Привіт, як справи?» копірайтеру, якому в 2023 році ви сказали, що він тепер нікому не потрібен. Хтозна.